
การใช้งานด้วย REST API
คู่มือนี้สำหรับการเชื่อมต่อผ่าน HTTP โดยตรง หากต้องการเริ่มต้นอย่างรวดเร็วด้วย CLI หรือ JavaScript SDK ดู เริ่มต้นใช้งาน (Quickstart)
การใช้งาน API มี 2 ขั้นตอน
หากมี URL ของไฟล์ที่ระบบเข้าถึงได้อยู่แล้ว การใช้งานหลักมี 2 endpoint
| ขั้นตอน | Endpoint | หน้าที่ |
|---|---|---|
| 1. ส่งงานถอดเสียง | POST /new-transcribe |
ส่ง URL ไฟล์เสียงเพื่อสร้างงานใหม่ ระบบตอบกลับ job_id |
| 2. ตรวจสอบสถานะ | GET /status |
ตรวจสอบความคืบหน้าด้วย job_id จนได้ลิงก์ดาวน์โหลดผลลัพธ์ |
หากไฟล์อยู่ในเครื่องและยังไม่มี URL สาธารณะ ใช้ POST /presigned-url เพื่อขอลิงก์อัปโหลดไฟล์ชั่วคราวก่อน แล้วนำ source_url ที่ได้มาส่งงานตามปกติ
endpoint เสริม: GET /jobs ดูประวัติงานและค้นหางานเดิมด้วยชื่อไฟล์, PUT /jobs/{job_id} บันทึกซับไตเติลที่แก้ไขและดาวน์โหลดผ่าน API, POST /short-topics เลือกช่วงไฮไลต์จากไฟล์ซับไตเติล และ GET /account/me ตรวจสอบตัวตนของผู้เรียก
ข้อมูลพื้นฐาน
| รายการ | ค่า |
|---|---|
| Base URL | https://api.lomasub.ai |
| การยืนยันตัวตน | HTTP Header Authorization: Bearer <API_KEY> |
| รูปแบบข้อมูล | JSON (Content-Type: application/json) ยกเว้น /short-topics ที่เป็น multipart/form-data |
| ลิงก์ผลลัพธ์ | presigned GET อายุ 86 400 วินาที (24 ชั่วโมง) |
สร้าง Personal API key จากหน้าบัญชีใน editor แล้วส่งเป็น bearer token หรือใช้ session cookie ใน browser แต่ละ key เข้าถึงเฉพาะงานของเจ้าของและใช้โควตาบัญชีเดียวกัน key ที่ผิด/ถูกยกเลิกตอบ 401 บัญชีที่ไม่เปิดใช้งานตอบ 403 ส่วน shared secret ของ worker เป็น credential ภายใน ไม่ใช่ key สำหรับผู้ใช้
อัปโหลดไฟล์ในเครื่องและสร้างซับไตเติล
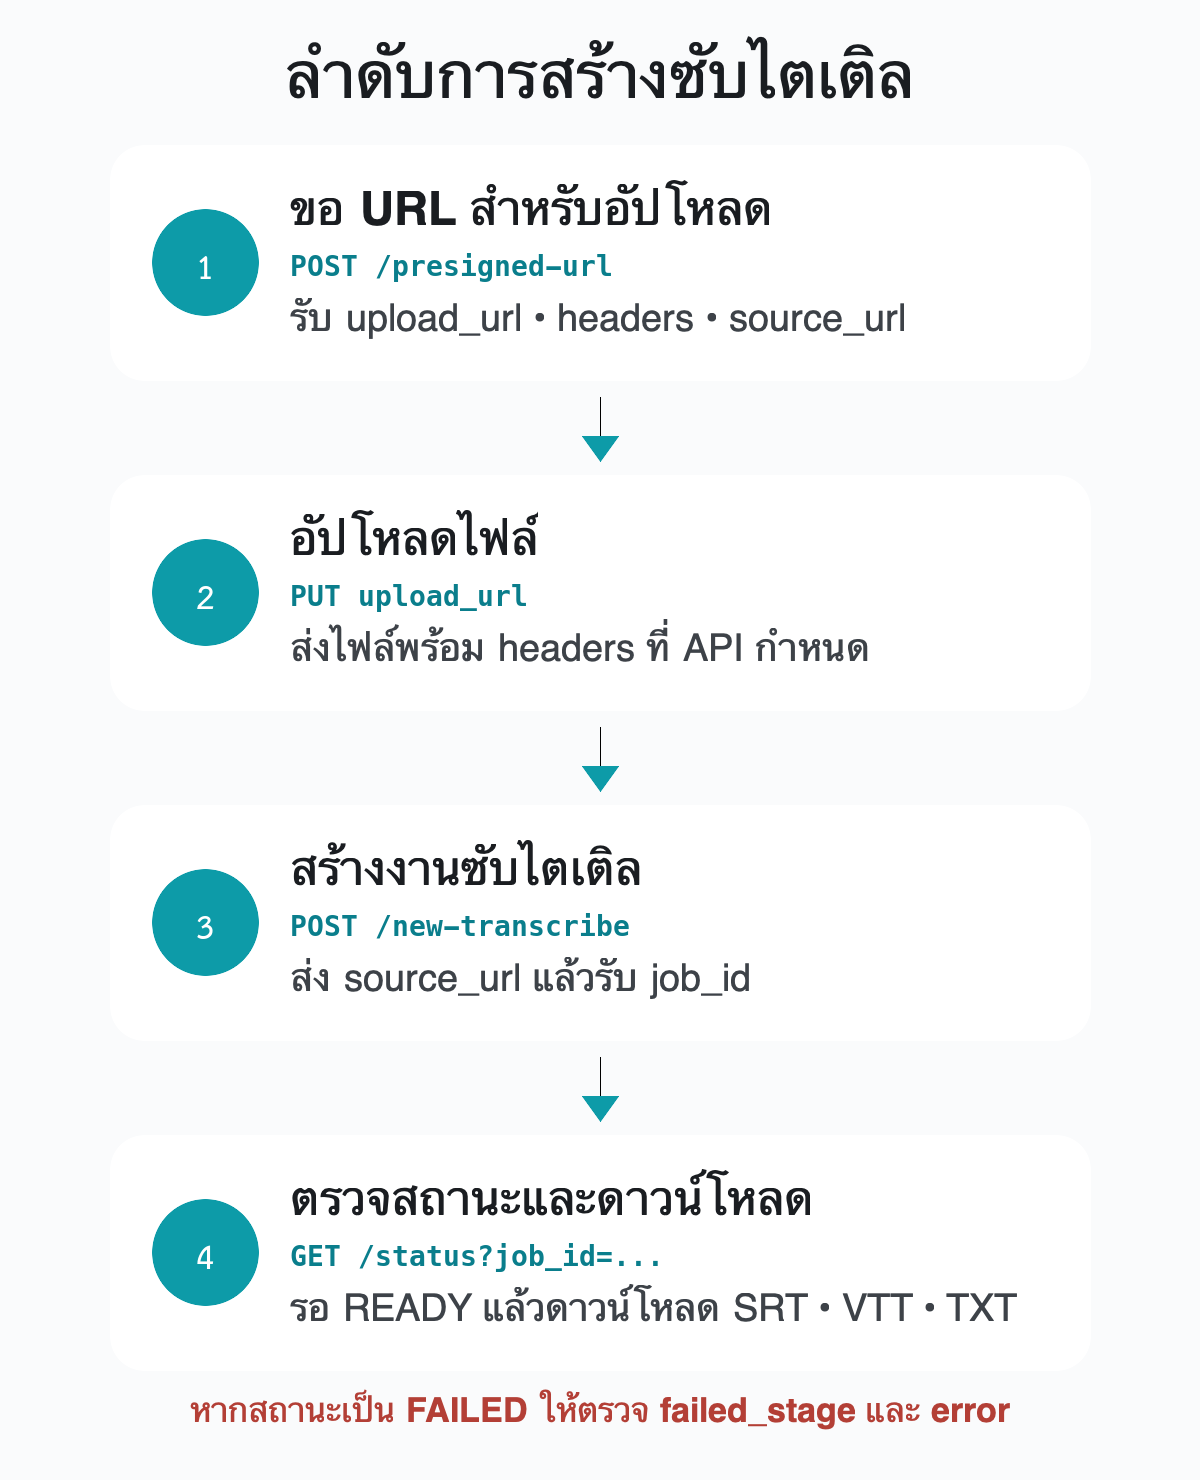
สำหรับไฟล์ในเครื่อง กระบวนการทั้งหมดมี 4 ขั้นตอน ได้แก่ ขอ URL สำหรับอัปโหลด → อัปโหลดไฟล์ → สร้างงานซับไตเติล → ตรวจสอบสถานะและดาวน์โหลดผลลัพธ์
ข้อกำหนดเบื้องต้น
ก่อนเริ่มต้น คุณต้องมีสิ่งต่อไปนี้
- API key สำหรับเรียก Loma Sub API — สร้าง Personal API key จากหน้าบัญชีใน editor
- Python 3
- ไฟล์เสียงหรือวิดีโอในเครื่อง ตัวอย่างนี้ใช้ไฟล์
audio.mp3
หากใช้ไฟล์ชนิดอื่น ให้เปลี่ยนชื่อไฟล์และ MIME type ในตัวอย่าง Python ให้ตรงกับไฟล์จริง เช่นใช้ video/mp4 สำหรับไฟล์ MP4
เก็บ API key ไว้ในตัวแปรสภาพแวดล้อมเพื่อไม่ให้เขียนรหัสลับลงในโปรแกรมโดยตรง
export LOMA_API_SECRET_KEY="<your-api-key>"
ขั้นตอนที่ 1 — ขอ URL สำหรับอัปโหลดไฟล์
เรียก POST /presigned-url โดยส่งชื่อไฟล์และ MIME type ระบบจะคืนค่าที่สำคัญดังนี้
upload_url— URL ชั่วคราวสำหรับอัปโหลดไฟล์headers— HTTP headers ที่ต้องใช้ตอนอัปโหลดsource_url— URL ของไฟล์หลังจากอัปโหลดสำเร็จ
ตัวอย่าง request body:
{
  "filename": "audio.mp3",
  "content_type": "audio/mpeg"
}
ตัวอย่าง response:
{
  "method": "PUT",
  "upload_url": "https://...presigned-upload-url...",
  "headers": {
    "Content-Type": "audio/mpeg",
    "x-amz-acl": "public-read"
  },
  "source_url": "https://.../tmpupload/example.mp3",
  "expires_in_seconds": 86400
}
ขั้นตอนที่ 2 — อัปโหลดไฟล์
ส่งไฟล์ไปยัง upload_url ด้วย HTTP method และ headers ที่ได้รับจากขั้นตอนก่อนหน้า โดยต้องส่ง headers ให้ครบและมีค่าตรงกับ response
การอัปโหลดไปยัง upload_url ไม่ต้องส่ง API key หรือ Authorization header เพราะสิทธิ์สำหรับอัปโหลดรวมอยู่ใน URL แล้ว เมื่อคำขออัปโหลดสำเร็จจึงนำ source_url ไปใช้สร้างงานซับไตเติลได้
ขั้นตอนที่ 3 — สร้างงานซับไตเติล
เรียก POST /new-transcribe พร้อม source_url จากขั้นตอนที่ 1 ภาษาของเสียง และ filename เพื่อให้งานมีชื่อแสดงในประวัติงาน (GET /jobs)
{
  "source_url": "https://.../tmpupload/example.mp3",
  "filename": "audio.mp3",
  "language": "th"
}
ระบบจะตอบกลับ job_id สำหรับใช้ติดตามงาน
{
  "job_id": "0b8a4f3e-6c1d-4a9b-9f2e-7d5c3b1a8e64",
  "status_url": "https://api.lomasub.ai/status?job_id=0b8a4f3e-6c1d-4a9b-9f2e-7d5c3b1a8e64",
  "state": "QUEUED"
}
ขั้นตอนที่ 4 — ตรวจสอบสถานะและดาวน์โหลดผลลัพธ์
เรียก GET /status พร้อม job_id เป็นระยะ แนะนำให้เรียกทุก 1–3 วินาที
- เมื่อ
stateเป็นREADYหมายถึงงานเสร็จสมบูรณ์และดาวน์โหลดผลลัพธ์ได้ - เมื่อ
stateเป็นFAILEDหมายถึงงานล้มเหลว ให้ตรวจสอบfailed_stageและerror - สถานะอื่นหมายถึงงานยังอยู่ในคิวหรือกำลังประมวลผล
เมื่อสถานะเป็น READY response จะมี URL สำหรับดาวน์โหลดผลลัพธ์
{
  "job_id": "0b8a4f3e-6c1d-4a9b-9f2e-7d5c3b1a8e64",
  "state": "READY",
  "srt_url": "https://...presigned.../result.srt?...",
  "vtt_url": "https://...presigned.../result.vtt?...",
  "compact_url": "https://...presigned.../result.compact.txt?...",
  "karaoke_vtt_url": "https://...presigned.../result.karaoke.vtt?...",
  "words_url": "https://...presigned.../result.words.json?...",
  "debug_vtt_url": "https://...presigned.../result.debug.vtt?..."
}
URL ดาวน์โหลดเป็น presigned URL ที่มีอายุ 24 ชั่วโมง หาก URL หมดอายุ ให้เรียก GET /status ด้วย job_id เดิมอีกครั้งเพื่อรับ URL ชุดใหม่
ตัวอย่าง Python แบบครบวงจร
ตัวอย่างต่อไปนี้ใช้เฉพาะ Python standard library เพื่อขอ URL อัปโหลด อัปโหลดไฟล์ สร้างงาน ตรวจสอบสถานะ และดาวน์โหลดผลลัพธ์ที่ระบบส่งกลับมา
import json
import os
import time
import urllib.parse
import urllib.request

API_BASE = "https://api.lomasub.ai"
API_KEY = os.environ["LOMA_API_SECRET_KEY"]
INPUT_FILE = "audio.mp3"
CONTENT_TYPE = "audio/mpeg"


def call_api(path, payload=None):
    data = None
    method = "GET"
    if payload is not None:
        data = json.dumps(payload).encode("utf-8")
        method = "POST"

    request = urllib.request.Request(
        f"{API_BASE}{path}",
        data=data,
        method=method,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
    )
    with urllib.request.urlopen(request, timeout=60) as response:
        return json.loads(response.read())


# 1) ขอ presigned URL สำหรับอัปโหลด
upload = call_api(
    "/presigned-url",
    {
        "filename": os.path.basename(INPUT_FILE),
        "content_type": CONTENT_TYPE,
    },
)

# 2) อัปโหลดไฟล์ด้วย method และ headers ที่ API กำหนด
with open(INPUT_FILE, "rb") as audio_file:
    upload_request = urllib.request.Request(
        upload["upload_url"],
        data=audio_file.read(),
        method=upload["method"],
        headers=upload["headers"],
    )
    with urllib.request.urlopen(upload_request, timeout=300):
        pass

# 3) สร้างงานซับไตเติลด้วย source_url ของไฟล์ที่อัปโหลดแล้ว
job = call_api(
    "/new-transcribe",
    {
        "source_url": upload["source_url"],
        "filename": os.path.basename(INPUT_FILE),
        "language": "th",
    },
)
job_id = job["job_id"]
print("job created:", job_id)

# 4) ตรวจสอบสถานะประมาณทุก 1 วินาที
query = urllib.parse.urlencode({"job_id": job_id})
while True:
    status = call_api(f"/status?{query}")
    state = status["state"]
    print("state:", state)

    if state == "READY":
        break
    if state == "FAILED":
        raise RuntimeError(
            f"{status.get('failed_stage')}: {status.get('error')}"
        )

    time.sleep(1)

# 5) ดาวน์โหลดผลลัพธ์ทุกชนิดที่มีใน response
outputs = {
    "srt_url": "result.srt",
    "vtt_url": "result.vtt",
    "compact_url": "result.compact.txt",
    "karaoke_vtt_url": "result.karaoke.vtt",
    "words_url": "result.words.json",
    "debug_vtt_url": "result.debug.vtt",
}
for url_field, output_name in outputs.items():
    if url_field in status:
        urllib.request.urlretrieve(status[url_field], output_name)
        print("saved:", output_name)
เมื่อโปรแกรมทำงานสำเร็จ จะได้ไฟล์ result.srt และผลลัพธ์ประกอบอย่าง result.vtt, result.compact.txt, result.karaoke.vtt, result.words.json และ result.debug.vtt ตาม URL ที่ API ส่งกลับมา